Imagine pedir a um agente de IA: “altere a validação de desconto”. Ele abre o repositório e encontra 3.000 arquivos. Se tratar tudo como texto, pode procurar a palavra desconto, receber 87 resultados e iniciar uma excursão turística pelo código. Com sorte, volta antes do almoço.
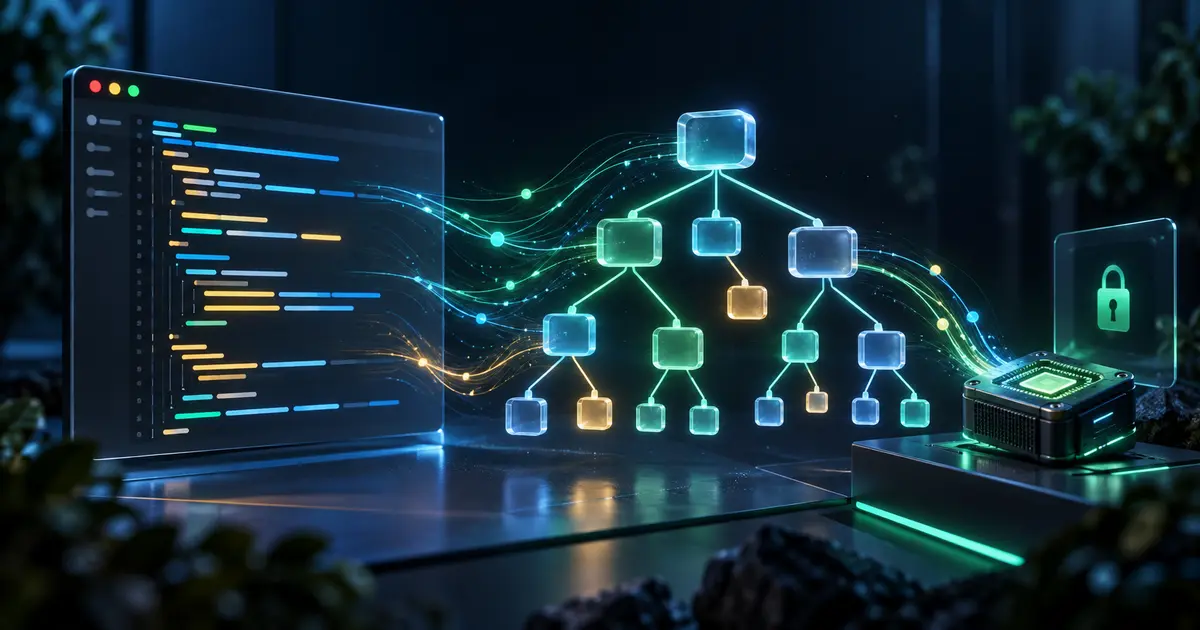
Um parser oferece um mapa melhor. Em vez de enxergar caracteres em sequência, ele reconhece funções, classes, chamadas, argumentos e relações de aninhamento. É a diferença entre procurar “farmácia” em todas as placas da cidade e consultar um mapa que já sabe o que é rua, prédio e endereço.
É aí que entram as árvores sintáticas e o parseamento local.
Primeiro: AST e CST não são exatamente a mesma coisa
O termo AST, ou Abstract Syntax Tree, virou uma forma popular de falar sobre a estrutura do código. Uma AST remove detalhes que não importam para a análise, como parte da pontuação. Já uma CST, Concrete Syntax Tree, preserva mais elementos da sintaxe original.
Essa distinção importa porque o Tree-sitter, ferramenta muito usada em editores e agentes, se define como gerador de parser e biblioteca de parseamento incremental que produz uma árvore sintática concreta. Portanto, dizer “AST do Tree-sitter” é um atalho comum, mas tecnicamente impreciso.
Na prática, ambas transformam texto em nós relacionados. Considere:
const total = price + shipping;Um parser pode identificar uma declaração, um nome, uma atribuição e uma expressão binária com dois identificadores. Agora o sistema consegue perguntar “onde esta função é declarada?” ou “quais chamadas possuem três argumentos?” sem depender apenas de palavras iguais.
O que significa parsear localmente
Parseamento local significa executar essa análise no computador ou ambiente do desenvolvedor, antes de pedir raciocínio ao modelo. O parser é determinístico: recebe código e gramática, devolve uma árvore. Não precisa “imaginar” se algo parece uma função.
O Tree-sitter também é incremental. Quando uma pequena parte do arquivo muda, ele pode reaproveitar a árvore anterior e recalcular as regiões afetadas. Isso ajuda editores a responder enquanto digitamos e permite que ferramentas acompanhem repositórios vivos sem reprocessar tudo do zero.
Depois do parseamento, consultas estruturais localizam padrões. O sistema de queries do Tree-sitter usa padrões sobre tipos de nós; ferramentas como o ast-grep aplicam a mesma ideia a busca, lint e reescrita estrutural em várias linguagens.
O fluxo fica mais inteligente:
- arquivos são descobertos localmente;
- o parser cria ou atualiza suas árvores;
- símbolos e relações relevantes são selecionados;
- apenas o contexto necessário segue para o modelo;
- a alteração volta e é validada por parser, tipos e testes.
Repare no detalhe: o modelo continua importante. Só deixou de receber o repositório como quem recebe uma mudança inteira dentro de uma caixa sem etiquetas.
Menos contexto não significa contexto pior
Janelas grandes convidam a uma solução aparentemente simples: “mande tudo”. O problema é que repositórios reais podem ultrapassar a janela, aumentar custo e misturar pistas úteis com dezenas de arquivos parecidos.
O Aider descreve uma abordagem de mapa de repositório baseado em Tree-sitter: extrai definições importantes, relaciona referências e seleciona o que cabe no orçamento de tokens. Não é uma árvore completa enviada ao modelo; é uma representação compacta da arquitetura relevante.
Pesquisas recentes reforçam que encontrar contexto é um problema próprio. O preprint CORE-Bench, com mais de 180 mil consultas, relata queda acentuada de desempenho quando a busca sai de snippets isolados e entra em cenários de agentes dentro de repositórios. Já o Agent Retrieval Bench, também ainda não revisado por pares, encontrou que nenhum método domina todos os tipos de tarefa; o RepoMap teve o melhor aproveitamento de contexto sob orçamento de 8 mil tokens, enquanto trajetórias de agentes deixaram de recuperar todos os arquivos relevantes em 27% a 35% das amostras.
Isso não prova que “AST vence embeddings”. Prova algo menos vendável, porém mais útil: recuperação de código é difícil e métodos diferentes se complementam.
Onde a árvore ajuda — e onde ela dá de ombros
Estrutura sintática é ótima para:
- localizar declarações, imports, chamadas e heranças;
- fazer mudanças repetitivas sem substituir texto inocente;
- resumir a forma de um arquivo sem enviar seu conteúdo inteiro;
- detectar quais regiões mudaram após uma edição;
- validar se a resposta ainda forma código sintaticamente válido.
Mas a árvore não conhece toda a verdade. Ela não sabe, sozinha, qual regra de negócio está correta, que uma função é chamada por reflexão, que um valor chega por configuração ou que dois serviços compartilham um contrato implícito. Sem resolução de tipos, grafo de chamadas, histórico, testes e documentação, ela pode produzir uma visão organizada — e incompleta.
Também existe uma sutileza de privacidade: parsear localmente não torna o fluxo inteiro local. Se a ferramenta enviar snippets, nomes ou mapas a uma API externa, esses dados saem do ambiente. O ganho é poder selecionar e minimizar o que será transmitido, não ganhar invisibilidade por decreto.
Uma arquitetura pragmática para agentes de código
Uma boa camada local costuma combinar quatro estratégias:
| Pergunta | Ferramenta mais adequada |
|---|---|
| Onde aparece este texto exato? | busca lexical |
| Onde existe esta estrutura de código? | query sintática |
| Onde este símbolo é definido ou usado? | índice de símbolos ou servidor de linguagem |
| Qual trecho parece relevante para a intenção? | recuperação semântica |
O agente pode começar barato e preciso: busca por caminho e símbolo, consulta estrutural, leitura de poucos trechos. Só amplia o raio quando a evidência pede. Depois da edição, roda formatação, análise de tipos e testes focados.
Uma pesquisa chamada CodeMEM propõe memória dinâmica guiada por AST para interações de desenvolvimento. Os autores reportam melhora de 12,2% no seguimento de instruções no turno atual e 11,5% no nível da sessão em seus benchmarks, além de duas a três rodadas a menos. São resultados promissores de um preprint em configuração específica, não um cheque em branco para qualquer produto.
O ponto principal
Agentes não precisam escolher entre “ler tudo” e “adivinhar”. O parseamento local cria uma camada intermediária: transforma código em estrutura pesquisável, preserva o orçamento de contexto e oferece verificações determinísticas antes e depois do modelo.
ASTs e CSTs não entendem o produto. LLMs não substituem parsers. Juntos, porém, formam uma dupla bem mais competente: um organiza os ossos do código; o outro tenta entender por que aquele esqueleto está cobrando frete com desconto.
Referências
- Tree-sitter. Introduction e Query syntax.
- Aider. Building a better repository map with Tree-sitter, 2023.
- Zhang et al. CORE-Bench: A Comprehensive Benchmark for Code Retrieval in the Era of Agentic Coding, preprint, 2026.
- Qin e Xie. Agent Retrieval Bench, preprint, 2026.
- Wang et al. CodeMEM: AST-Guided Adaptive Memory, preprint, 2026.