Um modelo poderoso recebe a tarefa “corrija o checkout”. Ele edita o arquivo certo, anuncia vitória e vai embora sem rodar um teste. O checkout continua quebrado, mas agora com autoestima.
É tentador concluir que falta inteligência ao modelo. Às vezes falta. Em muitos casos, porém, falta o ambiente que transforma capacidade em trabalho confiável: ferramentas adequadas, critérios de conclusão, limites, estado persistente, testes e feedback.
Esse conjunto é o harness. Harness Engineering é a disciplina de projetá-lo.
O que é um harness, afinal?
Em inglês, harness pode ser arreio, chicote de cabos ou estrutura de suporte. No mundo dos agentes, a metáfora útil é um sistema que conecta e controla a energia disponível.
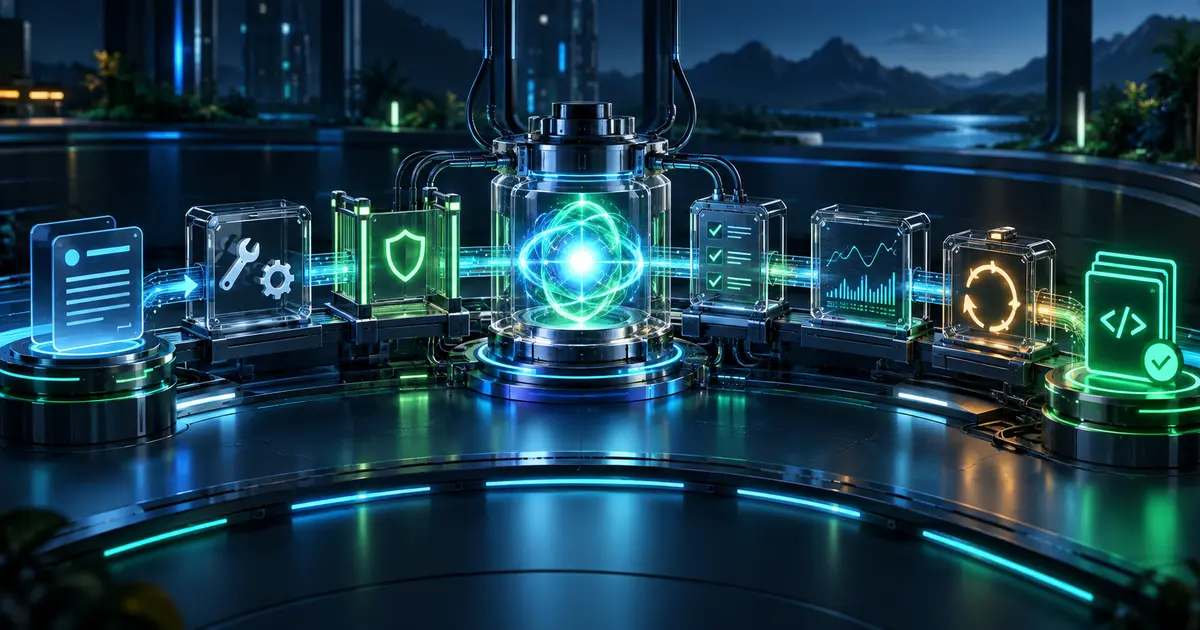
O modelo decide e gera. O harness organiza tudo ao redor:
- quais ferramentas podem ser usadas e com quais permissões;
- como o agente descobre o repositório e inicia o ambiente;
- que contexto entra em cada etapa;
- como progresso e decisões sobrevivem a outra sessão;
- quais testes provam que a tarefa terminou;
- quando repetir, parar ou pedir julgamento humano;
- quais logs, métricas e rastros permitem investigar falhas.
Não é apenas um prompt maior. Aliás, um manual gigantesco costuma ser um harness ruim disfarçado de documentação.
A mesma inteligência, dois resultados
Considere dois agentes com o mesmo modelo.
O primeiro recebe acesso irrestrito ao terminal e a frase “faça funcionar”. O segundo entra em um worktree isolado, lê instruções curtas por domínio, recebe a reprodução do bug, usa ferramentas com escopo, roda testes focados e só conclui quando o critério de aceitação é verificável.
O segundo não ganhou novos neurônios. Ganhou trilhos e instrumentos.
Foi essa a principal conclusão de um estudo de caso da OpenAI, Harness engineering: leveraging Codex in an agent-first world. Uma equipe relata ter construído um produto interno com aproximadamente um milhão de linhas geradas por agentes, cerca de 1.500 pull requests e tempo estimado em um décimo do desenvolvimento manual.
São números impressionantes, mas precisam da etiqueta correta: vêm da própria OpenAI, em um produto específico, com infraestrutura desenhada para Codex. Não são um benchmark independente nem promessa de produtividade universal. O valor do caso está menos no placar e mais no que precisou ser construído para chegar lá.
Legibilidade antes de autonomia
Um agente não observa o sistema como uma equipe que trabalha nele há cinco anos. Se a arquitetura vive apenas na cabeça de alguém, o agente recebe um quebra-cabeça sem a imagem da caixa.
A equipe da OpenAI tornou a aplicação legível por meio de ambientes isolados, acesso ao navegador, logs consultáveis, métricas, traces, linters estruturais e regras arquiteturais verificadas mecanicamente. Em vez de escrever “mantenha a arquitetura bonita”, codificou direções de dependência permitidas e invariantes de qualidade.
Essa diferença é fundamental:
Uma orientação pede bom comportamento. Uma restrição verificável torna o comportamento observável.
Documentação continua importante, mas deve funcionar como mapa. Instruções globais explicam onde encontrar regras específicas; arquivos locais descrevem apenas o domínio relevante. Quando tudo é prioridade máxima, o agente faz o que nós também faríamos: escolhe alguma coisa e torce.
O harness também carrega memória
Tarefas longas ultrapassam uma janela de contexto. A Anthropic estudou esse problema em Effective harnesses for long-running agents. O experimento separou um agente inicializador, responsável por preparar ambiente e requisitos, de sessões posteriores que avançavam uma funcionalidade por vez.
O estado sobrevivia em artefatos simples: lista estruturada de funcionalidades, arquivo de progresso e histórico Git. Cada sessão começava conferindo o ambiente e terminava deixando código e notas em condição limpa para a próxima.
O artigo relata dois erros recorrentes sem esse suporte: tentar fazer tudo de uma vez até acabar o contexto e, no extremo oposto, olhar um projeto parcialmente pronto e declarar que acabou. Qualquer semelhança com reformas residenciais é mera coincidência.
A lição não é criar um progress.txt em todo projeto. É tornar o estado externo, verificável e retomável. Dependendo do risco, isso pode ser uma máquina de estados, um banco de execução, commits, checkpoints ou eventos imutáveis.
As seis camadas de um harness útil
Um desenho pragmático pode ser revisado em seis camadas:
| Camada | Pergunta que precisa responder |
|---|---|
| ambiente | onde o agente trabalha sem afetar o que não deve? |
| contexto | como encontra a informação certa sem carregar o planeta? |
| ferramentas | quais ações existem, com esquemas e erros compreensíveis? |
| controle | quais permissões, limites, confirmações e condições de parada valem? |
| verificação | qual evidência demonstra sucesso ou falha? |
| observabilidade | como reconstruir o que aconteceu e quanto custou? |
O modelo atravessa essas camadas em um ciclo: observar, decidir, agir, receber feedback e atualizar o estado. Quando uma etapa falha, o harness deve devolver evidência utilizável — não apenas error: something went wrong, o equivalente digital a alguém gritar “deu ruim” e desligar o telefone.
Feedback loops sem roleta infinita
Agentes melhoram quando podem testar a própria ação. Um compilador, um teste unitário ou uma captura de tela oferece sinal mais concreto que “parece certo”. Mas loops precisam de orçamento e saída.
Defina:
- número máximo de tentativas;
- mudança exigida entre uma tentativa e outra;
- falhas que permitem correção automática;
- ações que exigem aprovação humana;
- condição terminal verificável;
- evidências preservadas ao encerrar.
Sem isso, “reflita e tente novamente” pode virar uma máquina sofisticada de repetir o mesmo erro com frases diferentes.
Permissões também devem ser proporcionais. Ler arquivos, editar uma branch e publicar em produção não pertencem ao mesmo nível de autoridade. O harness pode começar restrito, ampliar somente quando necessário e registrar cada efeito externo. Autonomia é uma escada, não um interruptor.
Benchmark de modelo não mede seu sistema inteiro
Resultados de agentes dependem do modelo, das ferramentas, do prompt, do ambiente e do avaliador. A METR mede horizontes de tarefas usando mais de cem problemas principalmente de software, ML e segurança. A própria organização alerta que desempenho varia com a configuração exata do agente e que tarefas bem especificadas e automaticamente avaliáveis são mais limpas que muito trabalho econômico real.
Portanto, escolher o líder de um ranking não encerra a arquitetura. Um benchmark ajuda a comparar capacidade sob um protocolo. Seu harness precisa medir o que importa no produto:
- taxa de tarefas concluídas com evidência;
- regressões introduzidas;
- custo e tempo por resultado aceito;
- intervenções humanas e seus motivos;
- falhas de permissão ou efeitos não planejados;
- recuperação após erro.
Teste também versões do harness com o mesmo modelo. Às vezes, uma ferramenta melhor descrita ou um teste de aceitação claro gera mais ganho do que trocar para um modelo caro. Sem experimento controlado, o mérito vai para quem tem o logotipo mais brilhante.
O ponto principal
Harness Engineering desloca a pergunta de “qual modelo escreve melhor?” para “qual sistema permite que o modelo trabalhe bem, com segurança e prova?”. É uma mudança de engenharia, não de vocabulário.
O modelo continua sendo o motor. Mas motores não definem rota, não instalam freios, não verificam o painel e não decidem quem recebe a chave. Um bom harness faz essa potência chegar ao destino — de preferência sem o checkout quebrado no banco de trás.
Referências
- OpenAI. Harness engineering: leveraging Codex in an agent-first world, 2026.
- Anthropic. Effective harnesses for long-running agents, 2025.
- Anthropic. Building a C compiler with a team of parallel Claudes, 2026.
- METR. Task-Completion Time Horizons of Frontier AI Models, atualização de maio de 2026.