Imagine um restaurante em que, a cada pedido, o cozinheiro precise reler o manual sanitário, decorar o cardápio, revisar todas as receitas e só então preparar um café. Tecnicamente correto. Operacionalmente, uma ótima forma de criar fila.
Aplicações com LLMs fazem algo parecido. Em cada chamada, repetem instruções do sistema, definições de ferramentas, exemplos e documentos. O prompt caching reaproveita o trabalho de processar essa parte estável. O café continua sendo feito na hora; o manual é que não precisa ser redescoberto a cada xícara.
Não é um cache de respostas
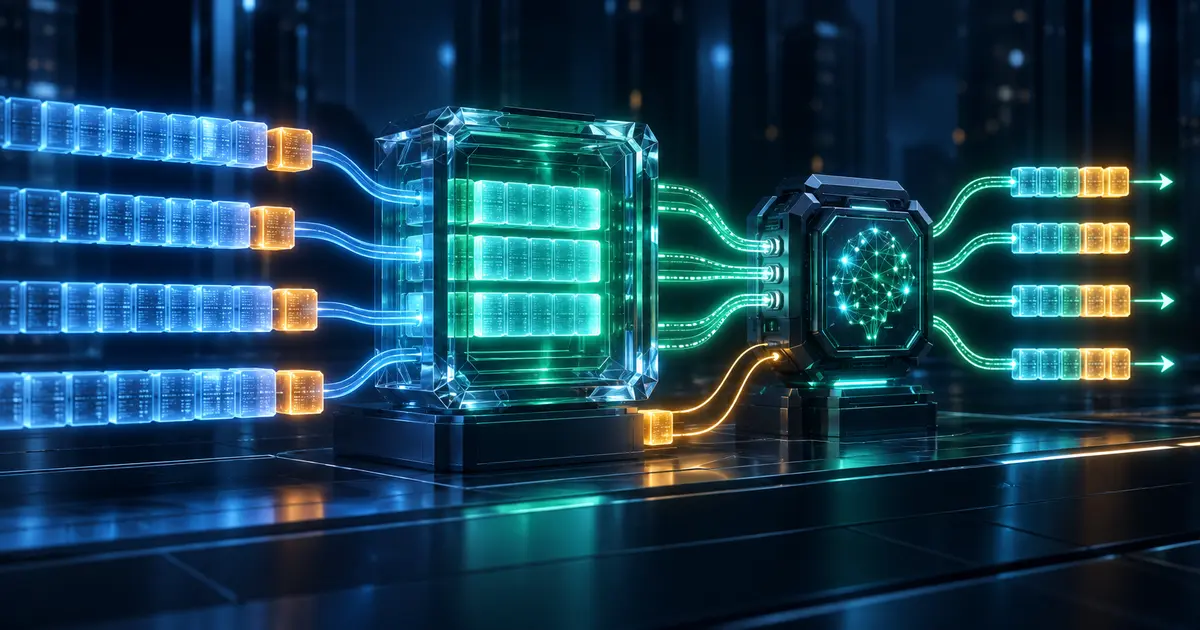
Em uma inferência, o modelo primeiro processa a entrada — fase chamada de prefill — e depois gera a saída token a token. Durante o prefill, calcula estados internos de atenção, conhecidos como estados ou tensores KV.
Segundo a documentação da OpenAI, o cache preserva esses estados para um prefixo reutilizável; não guarda simplesmente a resposta pronta. Uma nova pergunta ainda precisa ser processada e uma nova saída será gerada.
Isso separa três ideias que costumam cair no mesmo liquidificador:
| Técnica | O que reaproveita | Resultado pode mudar? |
|---|---|---|
| cache de resposta | a saída completa | normalmente não |
| cache semântico | uma resposta para pergunta semelhante | depende da política |
| prompt caching | o processamento de um prefixo idêntico | sim, a geração é nova |
O terceiro caso é o nosso assunto. Ele melhora principalmente custo de entrada e tempo até o primeiro token. Não deixa o modelo “mais inteligente” e não acelera magicamente uma resposta longa cuja maior demora está no decode.
O adjetivo mais lucrativo é “estável”
Caches de prompt trabalham com prefixos. A parte comum precisa vir primeiro e permanecer igual; o conteúdo variável vem depois.
Uma organização típica é:
- definições de ferramentas;
- instruções de sistema e políticas;
- exemplos fixos;
- documentos ou contexto compartilhado;
- histórico e pergunta variável.
Na Anthropic, a ordem do prefixo é tools, system e messages, até o bloco marcado para cache. A documentação do Claude recomenda colocar conteúdo estático no início e permite pontos de cache explícitos. A OpenAI oferece cache implícito nos modelos compatíveis e, em modelos recentes, também pontos explícitos. O Gemini habilita cache implícito por padrão nos modelos 2.5 ou posteriores e recomenda a mesma ideia: conteúdo grande e comum no começo, solicitações com prefixos semelhantes próximas no tempo.
O padrão é mais importante que a sintaxe de um fornecedor:
[ ferramentas + regras + exemplos estáveis ][ dados e pergunta variáveis ]
Trocar a data no topo, reordenar ferramentas ou gerar IDs aleatórios dentro do prefixo é como mudar a fechadura e reclamar que a chave de ontem parou de funcionar.
Cache hit não acontece por simpatia
Para reaproveitar o cálculo, o prefixo renderizado precisa corresponder. Pequenas mudanças antes do ponto de cache podem invalidar tudo que vem depois. Configurações do modelo e esquemas de ferramentas também podem participar dessa identidade, conforme o provedor.
Os tempos de retenção variam. Em setembro de 2026, a Anthropic documenta cinco minutos por padrão, renovados quando o cache é usado, e uma opção de uma hora com custo adicional. A OpenAI documenta retenção em memória tipicamente entre cinco e dez minutos de inatividade, podendo chegar a uma hora, além de opções estendidas em modelos compatíveis. Esses valores são características atuais de produto, não leis da física; confirme a documentação do modelo usado.
Também há limites mínimos de tokens. Um prompt curto pode nem ser elegível. Se sua instrução inteira cabe num guardanapo, construir uma estratégia de cache talvez seja a parte mais cara do sistema.
A conta tem três baldes
Uma forma útil de observar custo é separar:
entrada nova + escrita de cache + leitura de cache + saída
Na Anthropic, a documentação atual informa que uma escrita de cinco minutos custa 1,25 vez a entrada base, a de uma hora custa duas vezes, e a leitura normalmente custa 0,1 vez a entrada base, com exceções por modelo. Isso cria um ponto de equilíbrio: pagar uma escrita só vale quando o prefixo será reutilizado.
Exemplo ilustrativo, sem usar preço de modelo: um prefixo tem 10 mil tokens e a pergunta variável, 500. Se houver uma chamada, a escrita extra pode não compensar. Se cem chamadas reutilizarem o mesmo prefixo, processar aqueles 10 mil tokens do zero cem vezes seria um belo programa de fidelidade — para o fornecedor.
O benchmark publicado pela AWS sobre prompt caching no Bedrock reporta reduções de latência de até 85% e de custo de até 90% em modelos e cargas compatíveis. O “até” merece holofote: são limites observados pelo fornecedor, dependentes de tamanho, repetição, intervalo e proporção entre entrada e saída. No próprio material, uma carga com apenas 2 mil tokens estáticos e muito conteúdo dinâmico aparece como caso de benefício limitado.
Um desenho que costuma funcionar
Considere um agente de suporte técnico:
- estável por versão: política, tom, esquema de resposta e ferramentas;
- estável por hora: catálogo ou manual grande;
- dinâmico por sessão: histórico do cliente;
- dinâmico por chamada: nova pergunta e resultados de ferramentas.
Colocar tudo em um único bloco perde oportunidades. Separar por velocidade de mudança permite escolher pontos e retenções coerentes. Quando suportado, até o pré-aquecimento pode preparar o prefixo antes do pico de tráfego — mas só faz sentido se uso real vier antes da expiração.
O cache também conversa com arquitetura. Uma versão nova de ferramenta deve mudar o prefixo de propósito. Uma implantação gradual pode usar uma chave ou versão consistente para não misturar contratos. Conteúdo personalizado precisa ficar depois da parte compartilhada, tanto para maximizar hits quanto para facilitar governança.
Meça antes de comemorar a economia
Quatro indicadores contam a história:
- taxa de tokens lidos do cache, não apenas número de requisições com algum hit;
- tempo até o primeiro token com cache frio e quente;
- custo efetivo por tarefa concluída, incluindo escritas e saídas;
- taxa de invalidação, segmentada por versão, ferramenta e rota.
Compare distribuições P50 e P95 em tráfego representativo. Um teste com duas chamadas consecutivas demonstra que a API funciona; não demonstra que seu produto mantém prefixos estáveis numa terça-feira de deploy.
E trate segurança com precisão. Prompt caching não é autorização, isolamento de tenant ou política de retenção. Consulte os controles de dados do provedor e nunca dependa do cache para esconder informações. Ele otimiza computação; não substitui arquitetura de segurança.
O ponto principal
Prompt caching estático é menos sobre apertar um botão e mais sobre projetar a ordem do contexto. Ferramentas, regras e exemplos estáveis vão para a frente. Dados voláteis ficam no fim. Métricas dizem se houve ganho.
Quando bem desenhado, o modelo não recebe menos informação e não devolve uma resposta velha. Ele apenas deixa de reler o mesmo manual inteiro para descobrir, pela centésima vez, onde fica a máquina de café.
Referências
- OpenAI. Prompt caching, documentação consultada em setembro de 2026.
- Anthropic. Prompt caching, documentação consultada em setembro de 2026.
- Google. Context caching — Gemini API, documentação consultada em setembro de 2026.
- AWS. Effectively use prompt caching on Amazon Bedrock, 2025.