Imagina un restaurante donde, con cada pedido, el cocinero debe releer el manual sanitario, memorizar el menú y repasar todas las recetas antes de preparar un café. Técnicamente correcto. Operativamente, una gran manera de formar una fila.
Las aplicaciones con LLM hacen algo parecido. En cada llamada repiten instrucciones del sistema, definiciones de herramientas, ejemplos y documentos. El prompt caching reutiliza el trabajo de procesar esa parte estable. El café se sigue preparando en el momento; el manual no necesita redescubrirse con cada taza.
No es una caché de respuestas
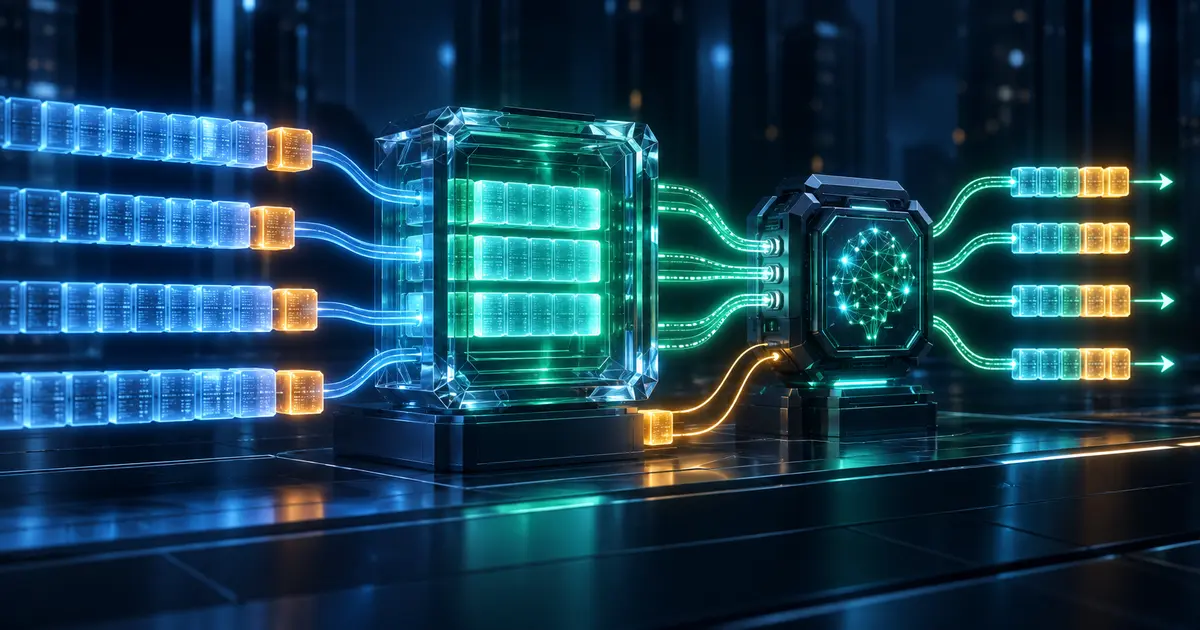
Durante la inferencia, el modelo primero procesa la entrada — fase de prefill — y luego genera la salida token por token. En el prefill calcula estados internos de atención, conocidos como estados o tensores KV.
Según la documentación de OpenAI, la caché conserva esos estados para un prefijo reutilizable; no guarda simplemente una respuesta terminada. Una pregunta nueva todavía debe procesarse y se generará una salida nueva.
| Técnica | Qué reutiliza | ¿Puede cambiar el resultado? |
|---|---|---|
| caché de respuesta | la salida completa | normalmente no |
| caché semántica | una respuesta a una pregunta similar | depende de la política |
| prompt caching | el procesamiento de un prefijo idéntico | sí, la generación es nueva |
El prompt caching mejora principalmente el costo de entrada y el tiempo hasta el primer token. No vuelve más inteligente al modelo ni acelera mágicamente una respuesta larga dominada por la generación de salida.
El adjetivo más rentable es “estable”
Las cachés de prompt trabajan con prefijos. El contenido compartido debe aparecer primero y permanecer idéntico; lo variable va después.
Un orden típico es:
- definiciones de herramientas;
- instrucciones del sistema y políticas;
- ejemplos fijos;
- documentos o contexto compartido;
- historial y pregunta variable.
Anthropic evalúa el prefijo en el orden tools, system y messages hasta el punto de caché. La documentación de Claude recomienda colocar lo estático al inicio y permite puntos explícitos. OpenAI ofrece caché implícita en modelos compatibles y controles explícitos en modelos recientes. Gemini activa caché implícita por defecto en modelos 2.5 o posteriores y sigue la misma idea: contenido grande y común al principio, y solicitudes con prefijos similares cercanas en el tiempo.
El patrón importa más que la sintaxis del proveedor:
[ herramientas + reglas + ejemplos estables ][ datos y pregunta variables ]
Poner una fecha cambiante, un ID aleatorio o herramientas reordenadas al inicio es como cambiar la cerradura y quejarse de que la llave de ayer dejó de funcionar.
Un cache hit no ocurre por simpatía
El prefijo renderizado debe coincidir. Pequeños cambios antes del punto de caché pueden invalidar todo lo posterior. La configuración del modelo y los esquemas de herramientas también pueden formar parte de la identidad, según el proveedor.
La retención varía. En septiembre de 2026, Anthropic documenta cinco minutos por defecto, renovados con el uso, y una opción de una hora con costo adicional. OpenAI documenta retención en memoria normalmente entre cinco y diez minutos de inactividad, con posibilidad de llegar a una hora y opciones extendidas en modelos compatibles. Son características actuales de producto, no leyes físicas; revisa la documentación del modelo utilizado.
También hay mínimos de tokens. Un prompt corto puede no ser elegible. Si toda la instrucción cabe en una servilleta, diseñar la estrategia de caché quizá sea la parte más cara del sistema.
La cuenta tiene varios compartimentos
Una forma útil de modelar el costo es:
entrada nueva + escritura de caché + lectura de caché + salida
La documentación actual de Anthropic indica que una escritura de cinco minutos cuesta 1,25 veces la entrada base, una de una hora cuesta el doble y una lectura normalmente cuesta 0,1 veces, con excepciones por modelo. Existe un punto de equilibrio: pagar la escritura solo compensa si el prefijo será reutilizado.
Ejemplo ilustrativo: un prefijo de 10.000 tokens y una pregunta variable de 500. Con una sola llamada, la escritura adicional puede no compensar. Con cien llamadas que reutilicen el prefijo, procesar esos 10.000 tokens desde cero cien veces sería un excelente programa de fidelidad — para el proveedor.
Un benchmark de AWS para Amazon Bedrock informa reducciones de latencia de hasta el 85% y de costo de hasta el 90% en modelos y cargas compatibles. “Hasta” merece un foco de luz: son límites observados por el proveedor que dependen del tamaño, repetición, intervalo y proporción entre entrada y salida. El mismo material muestra una carga con apenas 2.000 tokens estáticos y mucho contenido dinámico como un caso de beneficio limitado.
Un diseño que suele funcionar
Para un agente de soporte técnico:
- estable por versión: política, tono, esquema de respuesta y herramientas;
- estable por hora: catálogo o manual grande;
- dinámico por sesión: historial del cliente;
- dinámico por llamada: pregunta nueva y resultados de herramientas.
Separar por velocidad de cambio permite elegir puntos y retenciones coherentes. Una nueva versión de herramienta debe modificar el prefijo de forma intencional. Un despliegue gradual puede usar versiones consistentes para no mezclar contratos. El contenido personalizado debe ir después de la sección compartida, mejorando reutilización y gobernanza.
Mide antes de celebrar
Cuatro indicadores cuentan la historia:
- porcentaje de tokens leídos de caché, no solo solicitudes con algún hit;
- tiempo hasta el primer token con caché fría y caliente;
- costo efectivo por tarea terminada, incluyendo escrituras y salidas;
- tasa de invalidación, segmentada por versión, herramienta y ruta.
Compara distribuciones P50 y P95 con tráfico representativo. Dos llamadas consecutivas demuestran que la API funciona; no demuestran que el producto mantenga prefijos estables el día del despliegue.
El prompt caching no es autorización, aislamiento entre tenants ni política de retención. Revisa los controles de datos del proveedor y nunca dependas de la caché para ocultar información. Optimiza cómputo; no sustituye la arquitectura de seguridad.
La idea principal
El prompt caching estático trata menos de pulsar un botón y más de diseñar el orden del contexto. Herramientas, reglas y ejemplos estables van al inicio. Los datos volátiles, al final. Las métricas dicen si hubo ganancia.
Bien diseñado, el modelo no recibe menos información ni devuelve una respuesta antigua. Solo deja de releer el manual completo para descubrir, por centésima vez, dónde está la máquina de café.
Referencias
- OpenAI. Prompt caching, consultado en septiembre de 2026.
- Anthropic. Prompt caching, consultado en septiembre de 2026.
- Google. Context caching — Gemini API, consultado en septiembre de 2026.
- AWS. Effectively use prompt caching on Amazon Bedrock, 2025.