
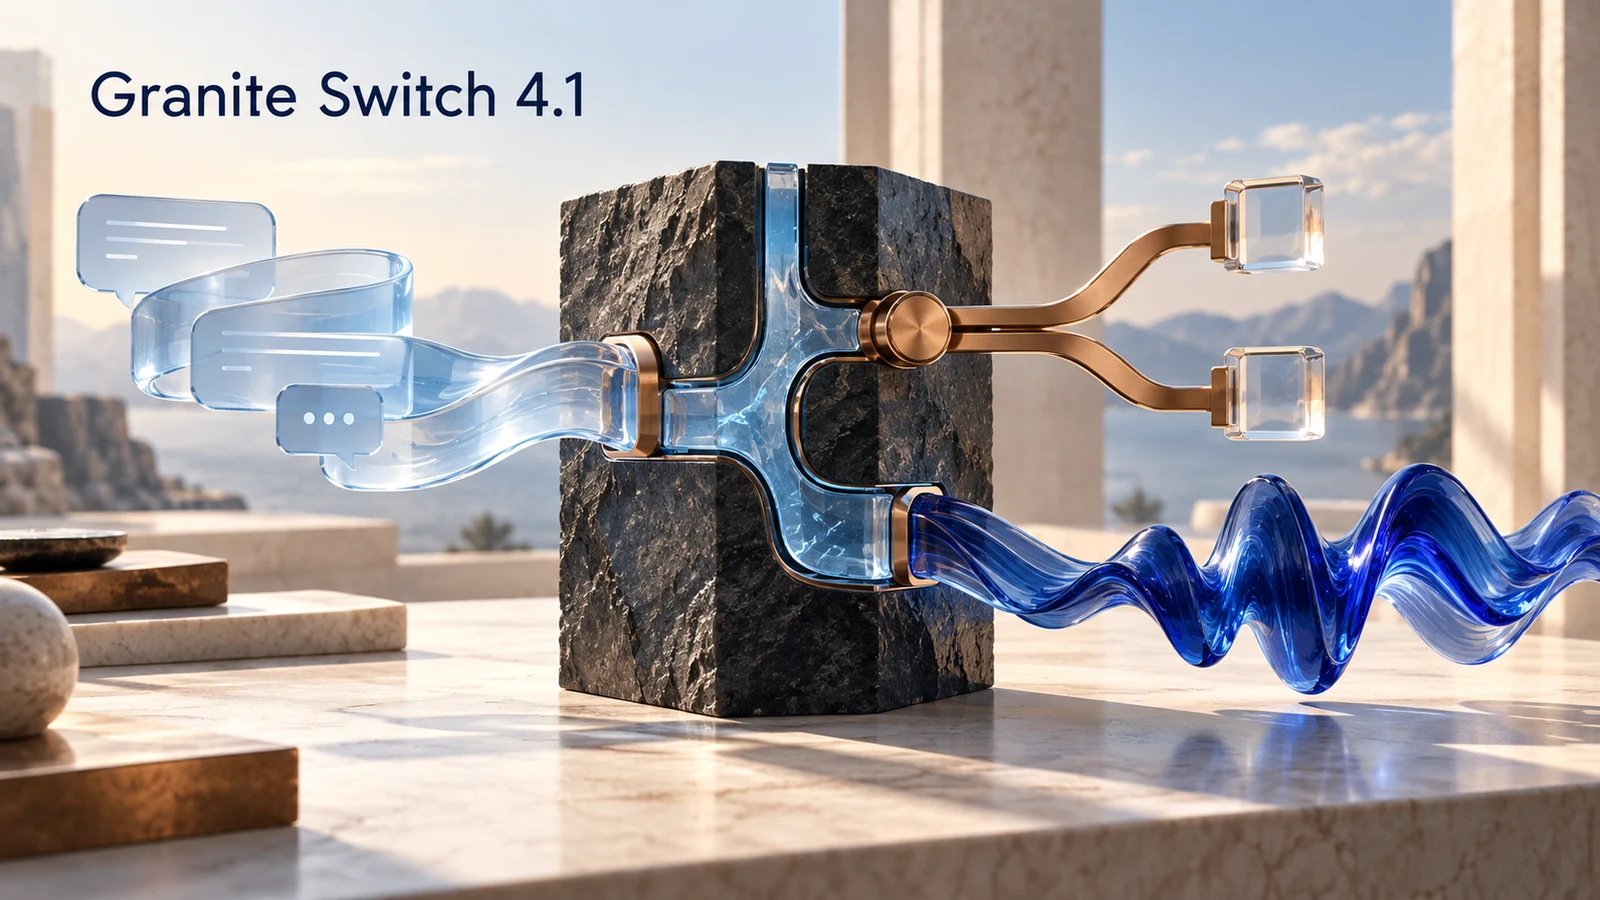
Um chamado de suporte pode exigir três trabalhos diferentes: entender o relato, escolher a fila responsável e verificar se há conteúdo sensível. Quando o pedido chega por voz, entra uma quarta etapa. A equipe precisa decidir como integrar essas funções sem transformar cada uma em um serviço difícil de operar.
O Granite Switch 4.1, apresentado pela IBM em 15 de outubro, propõe reunir conversa, decisões e transcrição em um endpoint. A novidade combina um modelo-base com adaptadores especializados, ativados conforme a tarefa. A ficha do checkpoint registra a liberação em 14 de outubro; o texto público de lançamento veio no dia seguinte.
O interesse não está em fazer o modelo conversar mais. Está em usar uma operação especializada quando a aplicação precisa escolher, classificar ou verificar algo, sem pedir uma explicação longa a cada chamada.
Granite Switch separa resposta aberta de decisão estruturada
A IBM descreve variantes com bases de 8B e 30B, adaptadores Decision e Guardian e um componente de reconhecimento de fala. Os adaptadores aLoRA permitem reutilizar o cache do contexto processado pelo modelo-base. A hipótese operacional é reduzir trabalho repetido quando várias verificações dependem do mesmo material.
Isso não equivale a um agente escolhendo sozinho a ferramenta ideal. No model card do checkpoint 8B, a aplicação seleciona o adaptador na chamada. Decision fornece probabilidades sobre opções; Guardian tem outra receita de invocação. São contratos diferentes, não respostas intercambiáveis.
Para uma central de atendimento, a leitura da MnzAI Labs seria testar primeiro uma decisão delimitada, como encaminhar um chamado. É mais fácil comparar a escolha com o histórico de uma equipe do que começar autorizando ações sobre contas ou pagamentos.
Compartilhar um endpoint simplifica a integração; não elimina a responsabilidade por cada decisão.
Áudio entra como transcrição, não como compreensão direta
A documentação de áudio chama esse caminho de alpha. O reconhecimento de fala produz texto, que depois segue para o modelo. O encoder padrão atende inglês, e a transcrição sai sem pontuação e em minúsculas. A documentação prevê trocar o componente para outros idiomas, o que já constitui outra configuração a validar.
Esse limite importa para o público brasileiro. Um exemplo de classificação por voz em inglês não demonstra atendimento confiável em português. Além disso, uma palavra transcrita incorretamente pode mudar a fila escolhida sem provocar um erro de infraestrutura.
Uma avaliação útil precisa preservar o áudio original e comparar a transcrição com a decisão final. Caso contrário, uma boa resposta do classificador pode esconder uma falha anterior.
O que conferir antes de consolidar serviços
Os artefatos são disponibilizados sob Apache 2.0. Isso permite inspecionar a implementação, mas não resolve a operação. O model card lista dependências específicas e alerta que probabilidades de Decision não são classificações certificadas para domínios novos. Guardian também não substitui testes de segurança da aplicação.
A IBM apresenta comparações favoráveis em tarefas selecionadas. A MnzAI Labs não reproduziu esses resultados, e eles não justificam prometer economia de GPUs ou superioridade geral. O teste relevante é o conjunto de chamados, documentos e erros da própria organização.
Antes de trocar serviços separados por um endpoint compartilhado, vale medir latência sob concorrência, qualidade por tarefa e impacto de uma falha comum. A arquitetura fica mais interessante quando reduz o esforço de operação sem dificultar descobrir qual componente errou.