
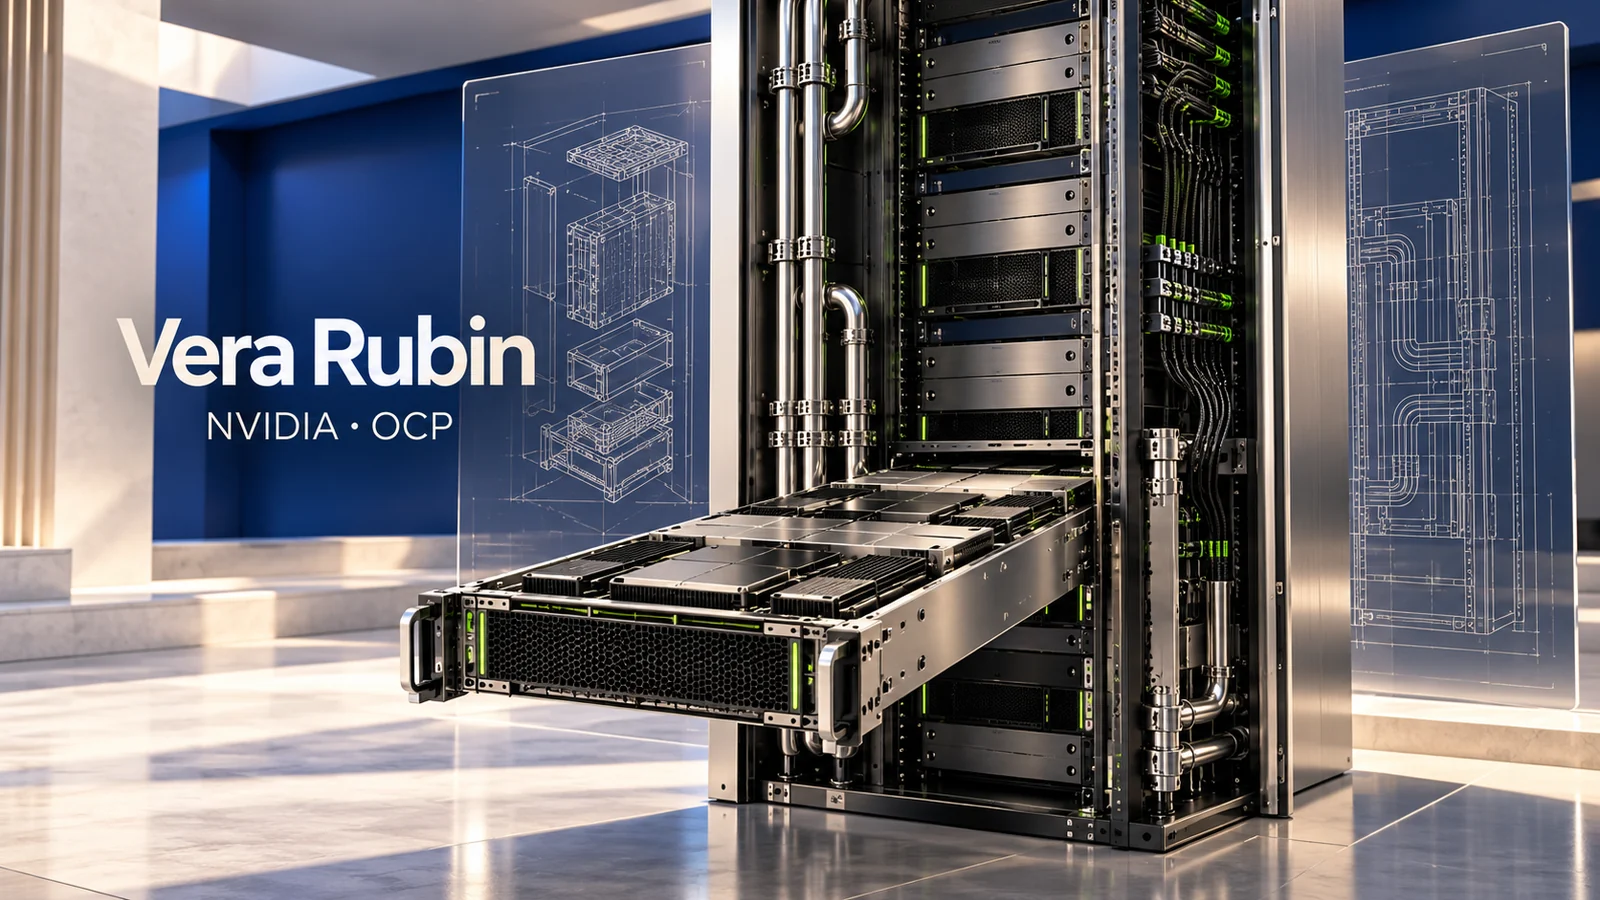
Comprar GPUs resolve apenas uma parte da infraestrutura de IA. Ainda é preciso alimentar e resfriar os racks, configurar a rede e descobrir se o conjunto suporta uma carga distribuída antes de entregar o ambiente ao time. É nessa distância entre equipamento e operação que entra o pacote apresentado pela NVIDIA no Open Compute Project Global Summit, em 12 de outubro.
A empresa contribuiu com projetos de racks e bandejas de computação Vera Rubin por meio da arquitetura MGX e destacou componentes abertos da plataforma DSX. O movimento amplia a base que fornecedores podem usar para integrar infraestrutura, sem significar que toda a tecnologia dos chips passou a ser aberta.
Do rack à operação
A parte de software merece atenção de quem constrói plataformas. O pacote inclui ferramentas de configuração de rede, validação de clusters, gerenciamento de racks e provisionamento de hardware. Em vez de começar cada implantação reunindo scripts independentes, operadores ganham componentes que podem examinar e incorporar aos próprios processos.
O Cluster Readiness Engine oferece um exemplo concreto. É um controlador Kubernetes que executa cargas de treinamento e comunicação, mede desempenho e registra nós com falhas. Seu repositório explicita um limite: ele não isola esses nós automaticamente. A decisão de colocá-los em quarentena continua com a plataforma que o integra.
Isso evita uma leitura exagerada de “certificação”. Passar em uma bateria de testes representa evidência sobre aquelas condições, não uma garantia permanente de saúde do cluster. Na prática, uma equipe ainda precisa definir o que bloqueia a entrada em produção, quem trata a falha e quando repetir a validação.
Capacidade instalada só vira capacidade útil quando a operação consegue detectar e tratar os pontos fracos do conjunto.
O que é novo e o que já estava em construção
O anúncio reúne contribuições e integrações no evento, mas nem tudo nasceu em 12 de outubro. O Cluster Readiness Engine já tinha a versão 0.6.0 publicada em 5 de outubro. A especificação Open Data Center 0.7.0 traz data efetiva de 27 de agosto; a especificação de comportamento diante de perturbações elétricas, de 17 de setembro.
Essa cronologia importa. O fato novo é a ampliação e articulação desse ecossistema no OCP, não a invenção de todos os seus componentes nesta segunda-feira. Os documentos mostram uma preocupação comum: fazer energia, resfriamento e computação caberem no mesmo projeto, com interfaces que fabricantes e operadores consigam implementar.
A leitura da MnzAI Labs é que a abertura pode reduzir incerteza de integração. Um projeto compartilhado ajuda fornecedores a trabalhar sobre requisitos conhecidos; código acessível permite revisar comportamento e adaptar automações. Nenhuma dessas vantagens elimina custo de hardware, dependência de componentes específicos ou responsabilidade operacional.
Onde isso entra na decisão de arquitetura
Para quem consome apenas APIs de modelos, a notícia não exige uma migração imediata. Para equipes que operam ou contratam capacidade de GPU, ela oferece perguntas melhores para a próxima avaliação de fornecedor.
O cluster foi testado com cargas distribuídas representativas? As falhas aparecem por nó? Existe um procedimento claro de isolamento e recuperação? O software de operação é auditável e tem um caminho de atualização definido?
Antes de comparar quantidade de aceleradores, vale comparar essas respostas. Elas ajudam a distinguir uma oferta de equipamento de uma plataforma que o time consegue manter funcionando.
Fontes em inglês: anúncio da NVIDIA no OCP, Cluster Readiness Engine e seus limites, release 0.6.0, Config Manager, Open Data Center 0.7.0 e especificação de resiliência elétrica.